

Default
Door Remote - 24 Sep 2026
ElevenLabs bouwt de stemlaag van AI, de modellen die tekst omzetten in spraak die menselijk klinkt. De meeste mensen komen het tegen wanneer ze met de klantenservice praten, vaak zonder het te beseffen. Klarna biedt er bijvoorbeeld eerstelijns telefonische ondersteuning voor 35 miljoen Amerikaanse klanten. Dat geldt ook voor Deutsche Telekom, Cisco, Adobe en een groeiende lijst van overheden. ElevenLabs verkoopt ook aan makers, die het platform gebruiken voor audioboeken, nasynchronisatie en muziek.
Het staat niet alleen in wat het doet. Sterker nog, het komt steeds vaker klanten tegen, waaronder Decagon, een conversatie-AI-platform dat zijn stemproduct op ElevenLabs heeft getraind en er nu mee concurreert. Maar de investeerders lijken zich niet al te veel zorgen te maken. Het bedrijf, dat naar eigen zeggen op 600 miljoen dollar aan jaarlijkse terugkerende inkomsten zit, wordt nu naar verluidt door zijn financiers gewaardeerd op 22 miljard dollar, ondanks dat het nog maar vier jaar oud is.
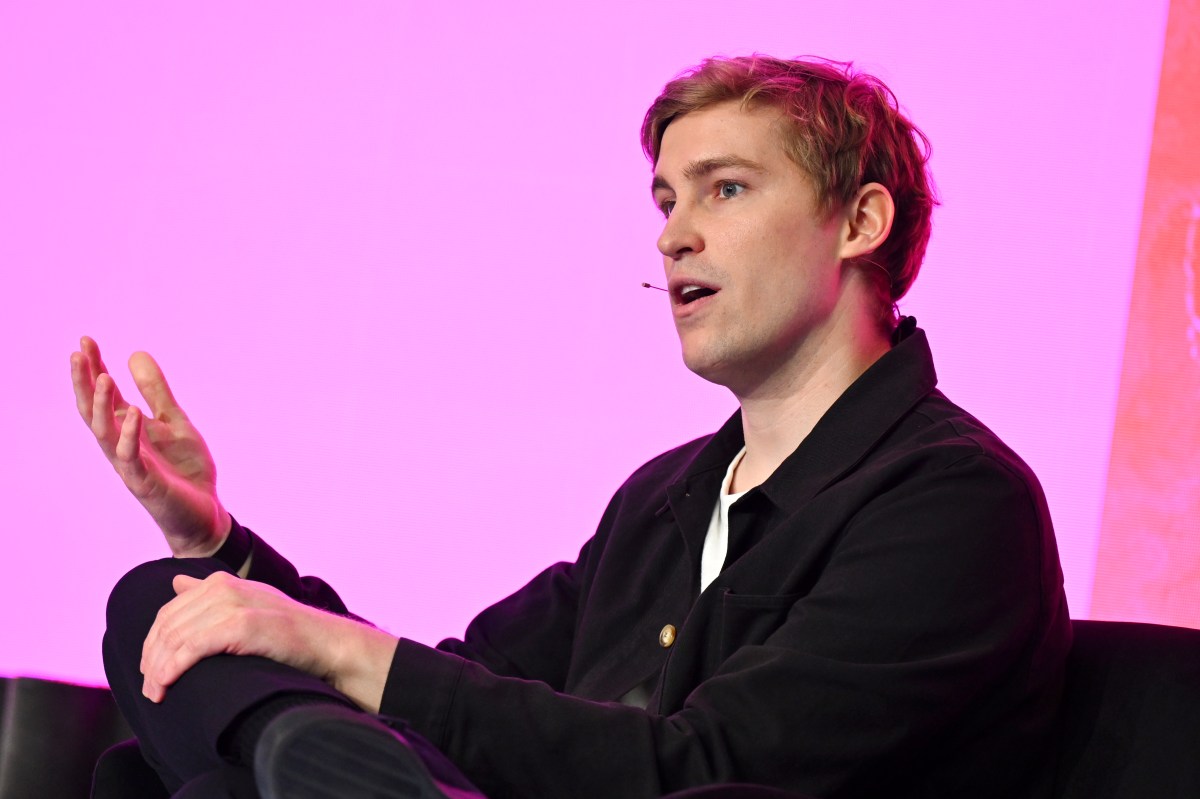
Om meer te begrijpen, interviewde ik mede-oprichter en CEO van ElevenLabs, Mati Staniszewski, op Nrth in Toronto, een lokale ondernemerschapsconferentie die voorheen bekend stond als Elevate. We hebben in korte tijd een reeks onderwerpen behandeld, waaronder de vraag of bedrijven klanten moeten vertellen wanneer ze met een AI praten (hij vindt dat dat moet), en of hij de brutomarges van het bedrijf zou kunnen bespreken. Het is niet verwonderlijk dat Staniszewski zei dat hij ze niet in detail kon bespreken, maar hij was duidelijk dat hij het niet erg vindt dat ze nog verder onder druk komen te staan als dit betekent dat het marktaandeel van het bedrijf moet worden vergroot.
Ons gesprek volgt, gecondenseerd en licht bewerkt. Je kunt het volledige gesprek hier bekijken.
Je kwam vorig jaar bij ons op TechCrunch Disrupt, waar je zei dat audiomodellen binnen een paar jaar op de markt zouden komen. Hoe zou u die voorspelling nu beoordelen?
Er is nog veel werk aan de winkel, en de kwaliteitsdelta die je alleen op modelniveau kunt bereiken is nog steeds aanzienlijk. Als we op de langere termijn denken, waarschijnlijk over drie tot vijf jaar, zullen die verschillen kleiner zijn. Wat we graag zouden doen, en de eersten willen zijn, is slagen voor de Turing-test voor conversationele AI. Je moet intelligentie combineren, maar je hebt ook emotionele intelligentie nodig. Je moet de emoties van de andere kant begrijpen, om te kunnen vertragen of iets te zeggen. Dat is nog niet gedaan.
Welk percentage van het bedrijf bestaat nu uit ondernemingen?
We hebben nu $600 miljoen aan ARR. Vijfenvijftig procent bestaat uit klassieke ondernemingen, en een groot percentage van de [resterende] 45% bestaat uit kleine en middelgrote bedrijven, ontwikkelaars, bouwers en makers.
Net als iedereen bij AI concurreert u steeds meer met uw klanten. Decagon heeft zijn stemproduct op u getraind en voert nu zoekopdrachten uit via zijn eigen modellen.
De lijnen worden vager. Als we denken aan modelbedrijven, platformbedrijven en applicatiebedrijven, had je in het verleden heel duidelijke splitsingen waar men begon en eindigde. Tegenwoordig is die lijn veel vager. In het geval van Anthropic is wat een modelbedrijf was, beslist een platform en in toenemende mate een breed scala aan applicaties. Ik denk dat dit zal doorgaan.
Uw klanten kunnen de ‘redeneerlaag’ kiezen uit een menu met opties bij ElevenLabs. Wat zie je in termen van het gebruik van grenslaboratoriummodellen versus open gewicht?
Het is minder een binaire keuze. Als je op het gebied van klantervaring belt en het alleen maar informatief is, voer je geen enkele actie uit. Je kunt veel van de open source-modellen gebruiken omdat je kennisbank definieert wat een goede ervaring is. Maar als het om financiële diensten gaat, wil je geauthenticeerd worden, wil je informatie over een transactie, misschien een terugbetaling. Er is geen ruimte voor fouten. Hier zullen grensmodellen nog steeds leidend zijn.
Sommige van die modellen met open gewicht zijn Chinees. De Amerikaanse overheid is een klant. Europese overheden zijn klanten. Hoe zijn die gesprekken?
Verschillend. Bij elke inzet zullen de modellen en de stemmen die we inzetten afhankelijk zijn van de casus. Als we samenwerken met de Poolse overheid of de Braziliaanse overheid, hebben zij hun eigen eisen. Het kan een open-weight-model zijn, een closed-source-model, hun eigen verfijnde model. [In Polen] is het een gezondheidszorgzaak. Er zijn patiënten die afspraken boeken in het hele gezondheidszorgsysteem, en 18% komt nooit opdagen. De inzet bestaat uit agenten die u bellen en herinneren. Ze hadden een reeks modellen die waren geoptimaliseerd op basis van hun kennis, en wij integreren met behoud van de dataresidentie.
Moeten bedrijven bekendmaken wanneer iemand met een agent praat in plaats van met een mens?
Ik denk dat er op dit moment openbaarmaking moet plaatsvinden. Momenteel zijn mensen er niet aan gewend, en het algemene patroon is dat je je bij dat telefoontje niet bedrogen wilt voelen. Maar over vijf jaar, als iedereen een eigen agent voor zich heeft, bel je en verwacht je een agent. Dan denk ik dat we als samenleving zullen veranderen. Er zijn goede manieren om dit te doen: als er 30 minuten moet worden gewacht op een mens, bied de klant dan een keuze. In bijna alle gevallen kiezen ze de makelaar en zijn dan verrast door hoe goed de ervaring is.
Wat zijn uw brutomarges, gegeven wat u betaalt voor modellen en gevolgtrekkingen?
Ik ga een vaag antwoord geven. Omdat we dat onderzoekselement hebben, kunnen we modellen op uiterst slimme manieren verfijnen en beperken. Maar als we een eventuele besparing aan de klant kunnen doorgeven, doen we dat. Het belangrijkste is nog steeds de waarde bewijzen en aanwezig zijn bij de klant. Dus als we kunnen investeren en die waarde kunnen bewijzen, vinden we het niet erg dat de marges kleiner worden, zodat we er samen daadwerkelijk van kunnen profiteren als de waarde in de komende vijf jaar wordt gecreëerd.
Je hebt miljoenen uren aan klantenservice-oproepen. Train jij erop? Hoeveel van uw trainingsgegevens zijn synthetisch?
Bij bepaalde bedrijven hebben we de modellen samen gemaakt. Ze wilden een specifiek model voor hun gebruiksscenario. Voor het overige bestond het grootste deel van de training niet zozeer uit de hoeveelheid gegevens, maar uit het annoteren van de gegevens. We hebben duizenden mensen intern op contractbasis die ons helpen niet alleen te annoteren wat er werd gezegd, maar ook wanneer mensen spraken, hoe ze dingen zeiden, welke emoties er werden gebruikt. Om accenten accuraat te kunnen detecteren, moesten we stemcoaches inschakelen.
Er is gemeld dat u voor een beursintroductie naar 2028 kijkt. Kunt u dat bevestigen?
We willen graag een bedrijf creëren dat de tand des tijds doorstaat. Wij bereiden de stichting voor om dit de komende jaren te kunnen doen. Maar of we dat doen, hangt af van de tijd en de plaats.
‘Jaren’ is erg vaag.
[Lacht.]
Backstage: waar kom je terecht als de grenslaboratoria langzamer moeten gaan werken?
Iedereen staat op één lijn om samen te werken aan het vinden van een manier om het tempo te bepalen. Of ze er openbaar over moeten zijn, en hoeveel van het mediagesprek of de regelgeving daarbij betrokken moet worden, dat is een ander onderwerp. Maar ja, we moeten allemaal de juiste voorzorgsmaatregelen nemen als we de technologie inzetten. We trainen niet de tekstmodellen en de intelligentiekant van modellen, wat de kern van het debat is.
Zou ElevenLabs kunnen worden ontmaskerd zoals Hugging Face was?
We zijn een stap verder, omdat we geen zelfreplicerende of terugkerende delen van de intelligentie van agenten inzetten. Onze technologie staat niet toe dat agenten meer agenten aanmaken. Elke klant gaat via KYC. Het cyberveiligheidsrisico is zeker een risico voor de rest van de wereld, maar we hebben een goede reeks voorzorgsmaatregelen getroffen.
Het staat niet alleen in wat het doet. Sterker nog, het komt steeds vaker klanten tegen, waaronder Decagon, een conversatie-AI-platform dat zijn stemproduct op ElevenLabs heeft getraind en er nu mee concurreert. Maar de investeerders lijken zich niet al te veel zorgen te maken. Het bedrijf, dat naar eigen zeggen op 600 miljoen dollar aan jaarlijkse terugkerende inkomsten zit, wordt nu naar verluidt door zijn financiers gewaardeerd op 22 miljard dollar, ondanks dat het nog maar vier jaar oud is.
Om meer te begrijpen, interviewde ik mede-oprichter en CEO van ElevenLabs, Mati Staniszewski, op Nrth in Toronto, een lokale ondernemerschapsconferentie die voorheen bekend stond als Elevate. We hebben in korte tijd een reeks onderwerpen behandeld, waaronder de vraag of bedrijven klanten moeten vertellen wanneer ze met een AI praten (hij vindt dat dat moet), en of hij de brutomarges van het bedrijf zou kunnen bespreken. Het is niet verwonderlijk dat Staniszewski zei dat hij ze niet in detail kon bespreken, maar hij was duidelijk dat hij het niet erg vindt dat ze nog verder onder druk komen te staan als dit betekent dat het marktaandeel van het bedrijf moet worden vergroot.
Ons gesprek volgt, gecondenseerd en licht bewerkt. Je kunt het volledige gesprek hier bekijken.
Je kwam vorig jaar bij ons op TechCrunch Disrupt, waar je zei dat audiomodellen binnen een paar jaar op de markt zouden komen. Hoe zou u die voorspelling nu beoordelen?
Er is nog veel werk aan de winkel, en de kwaliteitsdelta die je alleen op modelniveau kunt bereiken is nog steeds aanzienlijk. Als we op de langere termijn denken, waarschijnlijk over drie tot vijf jaar, zullen die verschillen kleiner zijn. Wat we graag zouden doen, en de eersten willen zijn, is slagen voor de Turing-test voor conversationele AI. Je moet intelligentie combineren, maar je hebt ook emotionele intelligentie nodig. Je moet de emoties van de andere kant begrijpen, om te kunnen vertragen of iets te zeggen. Dat is nog niet gedaan.
Welk percentage van het bedrijf bestaat nu uit ondernemingen?
We hebben nu $600 miljoen aan ARR. Vijfenvijftig procent bestaat uit klassieke ondernemingen, en een groot percentage van de [resterende] 45% bestaat uit kleine en middelgrote bedrijven, ontwikkelaars, bouwers en makers.
Net als iedereen bij AI concurreert u steeds meer met uw klanten. Decagon heeft zijn stemproduct op u getraind en voert nu zoekopdrachten uit via zijn eigen modellen.
De lijnen worden vager. Als we denken aan modelbedrijven, platformbedrijven en applicatiebedrijven, had je in het verleden heel duidelijke splitsingen waar men begon en eindigde. Tegenwoordig is die lijn veel vager. In het geval van Anthropic is wat een modelbedrijf was, beslist een platform en in toenemende mate een breed scala aan applicaties. Ik denk dat dit zal doorgaan.
Uw klanten kunnen de ‘redeneerlaag’ kiezen uit een menu met opties bij ElevenLabs. Wat zie je in termen van het gebruik van grenslaboratoriummodellen versus open gewicht?
Het is minder een binaire keuze. Als je op het gebied van klantervaring belt en het alleen maar informatief is, voer je geen enkele actie uit. Je kunt veel van de open source-modellen gebruiken omdat je kennisbank definieert wat een goede ervaring is. Maar als het om financiële diensten gaat, wil je geauthenticeerd worden, wil je informatie over een transactie, misschien een terugbetaling. Er is geen ruimte voor fouten. Hier zullen grensmodellen nog steeds leidend zijn.
Sommige van die modellen met open gewicht zijn Chinees. De Amerikaanse overheid is een klant. Europese overheden zijn klanten. Hoe zijn die gesprekken?
Verschillend. Bij elke inzet zullen de modellen en de stemmen die we inzetten afhankelijk zijn van de casus. Als we samenwerken met de Poolse overheid of de Braziliaanse overheid, hebben zij hun eigen eisen. Het kan een open-weight-model zijn, een closed-source-model, hun eigen verfijnde model. [In Polen] is het een gezondheidszorgzaak. Er zijn patiënten die afspraken boeken in het hele gezondheidszorgsysteem, en 18% komt nooit opdagen. De inzet bestaat uit agenten die u bellen en herinneren. Ze hadden een reeks modellen die waren geoptimaliseerd op basis van hun kennis, en wij integreren met behoud van de dataresidentie.
Moeten bedrijven bekendmaken wanneer iemand met een agent praat in plaats van met een mens?
Ik denk dat er op dit moment openbaarmaking moet plaatsvinden. Momenteel zijn mensen er niet aan gewend, en het algemene patroon is dat je je bij dat telefoontje niet bedrogen wilt voelen. Maar over vijf jaar, als iedereen een eigen agent voor zich heeft, bel je en verwacht je een agent. Dan denk ik dat we als samenleving zullen veranderen. Er zijn goede manieren om dit te doen: als er 30 minuten moet worden gewacht op een mens, bied de klant dan een keuze. In bijna alle gevallen kiezen ze de makelaar en zijn dan verrast door hoe goed de ervaring is.
Wat zijn uw brutomarges, gegeven wat u betaalt voor modellen en gevolgtrekkingen?
Ik ga een vaag antwoord geven. Omdat we dat onderzoekselement hebben, kunnen we modellen op uiterst slimme manieren verfijnen en beperken. Maar als we een eventuele besparing aan de klant kunnen doorgeven, doen we dat. Het belangrijkste is nog steeds de waarde bewijzen en aanwezig zijn bij de klant. Dus als we kunnen investeren en die waarde kunnen bewijzen, vinden we het niet erg dat de marges kleiner worden, zodat we er samen daadwerkelijk van kunnen profiteren als de waarde in de komende vijf jaar wordt gecreëerd.
Je hebt miljoenen uren aan klantenservice-oproepen. Train jij erop? Hoeveel van uw trainingsgegevens zijn synthetisch?
Bij bepaalde bedrijven hebben we de modellen samen gemaakt. Ze wilden een specifiek model voor hun gebruiksscenario. Voor het overige bestond het grootste deel van de training niet zozeer uit de hoeveelheid gegevens, maar uit het annoteren van de gegevens. We hebben duizenden mensen intern op contractbasis die ons helpen niet alleen te annoteren wat er werd gezegd, maar ook wanneer mensen spraken, hoe ze dingen zeiden, welke emoties er werden gebruikt. Om accenten accuraat te kunnen detecteren, moesten we stemcoaches inschakelen.
Er is gemeld dat u voor een beursintroductie naar 2028 kijkt. Kunt u dat bevestigen?
We willen graag een bedrijf creëren dat de tand des tijds doorstaat. Wij bereiden de stichting voor om dit de komende jaren te kunnen doen. Maar of we dat doen, hangt af van de tijd en de plaats.
‘Jaren’ is erg vaag.
[Lacht.]
Backstage: waar kom je terecht als de grenslaboratoria langzamer moeten gaan werken?
Iedereen staat op één lijn om samen te werken aan het vinden van een manier om het tempo te bepalen. Of ze er openbaar over moeten zijn, en hoeveel van het mediagesprek of de regelgeving daarbij betrokken moet worden, dat is een ander onderwerp. Maar ja, we moeten allemaal de juiste voorzorgsmaatregelen nemen als we de technologie inzetten. We trainen niet de tekstmodellen en de intelligentiekant van modellen, wat de kern van het debat is.
Zou ElevenLabs kunnen worden ontmaskerd zoals Hugging Face was?
We zijn een stap verder, omdat we geen zelfreplicerende of terugkerende delen van de intelligentie van agenten inzetten. Onze technologie staat niet toe dat agenten meer agenten aanmaken. Elke klant gaat via KYC. Het cyberveiligheidsrisico is zeker een risico voor de rest van de wereld, maar we hebben een goede reeks voorzorgsmaatregelen getroffen.